See it.
Reconstruct it.

가상 피팅(Virtual Try-On)과 3D 인체 복원을 연구하고, 결과를 논문과 공개 코드로 공유합니다. TF3D 도식은 네 방향의 깊이 영상(Depth Image)을 점군(Point Cloud)으로 바꾸고, 점군 정합(Registration)으로 하나의 3D 인체를 복원하는 과정을 단계별로 보여 줍니다.

TF3D · 4방향 깊이 영상 정합점은 논문 저장소의 실제 복원 결과(병합 모델)이며, 4방향 분할⁠·단계 움직임⁠·기준선은 설명용입니다

점군 데이터를 불러오는 중입니다…

정면⁠·후면⁠·좌측⁠·우측 깊이 영상 → 점군 생성

네 방향의 깊이 영상을 각각 점군으로 바꿉니다. 방향마다 좌표계가 달라 아직 서로 어긋나 있습니다.

Published, coded,
reproducible.

논문 수치는 각 논문의 실험 조건에서 보고된 연구 결과이며, DevChoco 제품의 성능을 뜻하지 않습니다.

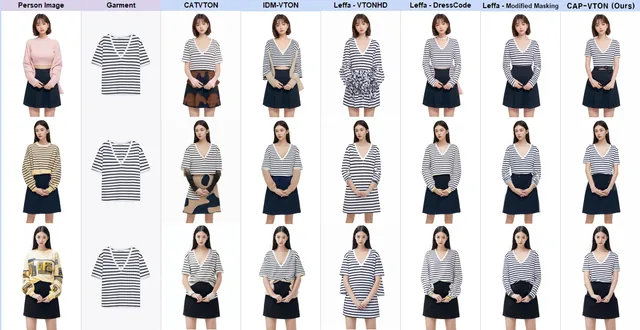
논문 비교 그림 발췌: 긴팔 상의를 입은 세 인물에게 같은 줄무늬 반팔을 여러 가상 피팅 방법으로 입힌 결과를 8열로 비교한 그림. 첫 두 열은 입력 인물과 의류, 마지막 열이 CaP-VTON 결과입니다.

Electronics · 2025 · 14(23), 4710Virtual Try-On

Clothing-Agnostic Pre-Inpainting Virtual Try-On

문제
긴팔 인물을 반팔⁠·민소매로 바꿔 입힐 때 원래 소매의 실루엣이 결과에 남고, 새로 드러나는 팔 피부가 부자연스럽게 생성되는 문제를 다룹니다.
기존 방법의 한계
비교 모델 Leffa는 확산 모델의 질감 왜곡을 줄였지만, 하의 영역 검출이 부정확하고 기존 의류의 실루엣이 합성 결과에 남는 한계가 있었습니다.
방법
DressCode 기반 다중 범주 마스킹으로 기존 의류 영역 전체를 지우고, Stable Diffusion 기반 피부 영역 복원(Skin Inpainting)으로 드러날 피부를 가상 피팅 전에 먼저 그립니다. 전처리 단계라 특정 가상 피팅 모델에 묶이지 않습니다.
확인한 것
시각 평가에서 기존 모델들과 달리 참조 의류의 소매 길이⁠·무늬⁠·스타일을 일관되게 재현했습니다.

논문에서 보고한 반팔 합성 정확도는 92.5%로, 비교 모델 Leffa의 77.1%보다 15.4%p 높았습니다. 논문 초록과 결론에 실린 수치이며, 긴팔 인물에 반팔 의류를 합성한 결과를 CLIP 모델이 자동으로 판정해 반팔로 분류된 비율입니다. 가상 피팅 전반의 정확도나 화질을 뜻하지 않습니다.
  • Multi-category masking
  • Skin pre-inpainting
  • Model-agnostic preprocessing
  • Extends Leffa
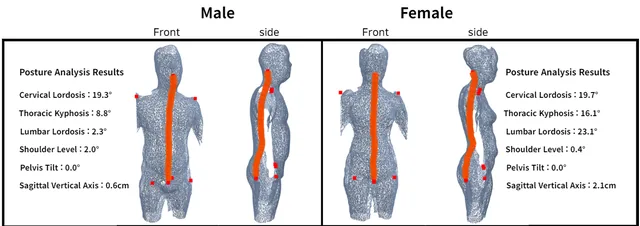
TF3D 논문 저장소 그림 발췌: 남녀 두 사람의 복원된 3D 인체 메시를 정면과 측면에서 보고, 추정한 척추 중심선과 자세 분석 값을 표시한 그림

Applied Sciences · 2026 · 16(2), 10963D Human Body

Spinal Line Detection for Posture Evaluation Through Training-Free 3D Human Body Reconstruction with 2D Depth Images

문제
자세 평가의 중요한 지표인 척추 중심선은 몸 안쪽 구조라 일반 2D 이미지만으로는 정확히 찾기 어렵습니다. 3D 인체를 복원해 척추 중심선을 추정하는 문제를 다룹니다.
기존 방법의 한계
여러 대의 RGB 카메라를 쓰는 방식은 비싼 장비와 복잡한 보정 절차가 필요하고, 이미지 한 장으로 복원하는 방식은 가림과 시점의 한계 때문에 척추처럼 안쪽 구조를 추정하기 어렵습니다.
방법
정면⁠·후면⁠·좌측⁠·우측 깊이 영상을 각각 점군으로 바꾸고, RANSAC·FPFH 기반 전역 정합과 ICP 정합으로 하나의 3D 인체로 합칩니다. 정점 수를 줄인 여러 해상도(LoD) 모델에서 척추 중심선을 각각 추정해 종합합니다.
확인한 것
학습 데이터나 복잡한 신경망 모델에 의존하지 않고 3D 인체를 복원해 척추 중심선을 추정했으며, 논문의 검증에서 정합 품질이 개선되었음을 확인했습니다.
  • 4-view depth
  • Global + fine registration
  • Adaptive vertex reduction
  • LoD ensemble

가상 피팅 전에 무엇을 제거하고 복원할까요?

CaP-VTON의 핵심은 가상 피팅 모델 자체보다 그 앞단의 전처리입니다. Input → Masking → Skin Inpainting → Virtual Try-On 네 단계를 눌러 각 단계의 입력⁠·처리⁠·출력을 확인해 보세요.

FitLight의 착용 이미지 엔진은 이 연구 코드에서 출발했지만 현재는 다른 생성 모델 백본을 씁니다. 위 논문의 반팔 합성 정확도 92.5% (비교 모델 77.1%, 15.4%p 상승)는 FitLight의 성능이 아닙니다.

논문 그림 발췌 · Electronics 2025
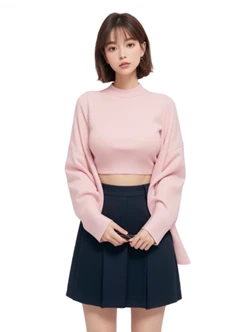
분홍색 긴소매 상의를 입은 입력 인물
입력 인물
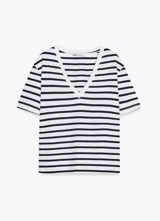
줄무늬 반소매 참조 의류
참조 의류

긴팔 인물에게 반팔 입히기

입력
긴팔 상의를 입은 인물 이미지와 반팔 참조 의류 이미지
처리
인물 이미지에서 인체 부위를 나누고(SCHP) 자세 정보를 추출합니다(OpenPose).
출력
다음 단계에서 쓸 인체 부위 지도와 자세 정보

의류 영역 마스킹

입력
인물 이미지와 인체 부위 지도
처리
DressCode 기반 다중 범주 마스킹으로 소매를 포함한 기존 의류 영역 전체를 지정합니다. 원래 옷의 실루엣이 결과에 남지 않게 하기 위해서입니다.
출력
의류 영역 마스크 (그림의 빨간 영역)

피부 영역 복원

입력
의류 영역 마스크와 자세 정보
처리
Stable Diffusion 인페인팅이 자세 조건(ControlNet)에 맞춰, 지운 영역에 팔 피부와 몸에 붙는 반팔 바탕을 먼저 그립니다.
출력
긴팔 실루엣이 사라진 전처리 이미지

가상 피팅

입력
전처리 이미지와 반팔 참조 의류
처리
전처리 이미지로 의류 마스크를 다시 만들고, VITON-HD 기반 Leffa 확산 모델이 참조 의류를 입혀 합성합니다.
출력
최종 착용 이미지

그림은 논문 그림 발췌이고, 단계 구분과 입력⁠·처리⁠·출력 설명은 설명용입니다.

Research trajectory.

DevChoco Lab은 회사 설립 전후에 수행한 AI 연구 경험을 바탕으로 운영됩니다. 여기에 소개한 논문은 모두 강원대학교 소속으로 발표된 연구이며, 저자와 소속은 학술지에 실린 그대로 표기합니다.

  1. 2025논문 게재
    CaP-VTON의류 종류와 무관한 마스킹과 사전 피부 복원을 결합한 가상 피팅
    • arXiv 제출 2025-09-22
    • Electronics 게재 2025-11-29
  2. 2026논문 게재
    TF3D_SpineDetect학습 없이 동작하는 3D 인체 복원과 척추 중심선 검출
    • arXiv 제출 2025-12-14
    • Applied Sciences 게재 2026-01-21
  3. 후속 연구연구 진행 중
    OVC-NetOccluded-View Completion Network for 3D Human Body Reconstruction · 공개된 논문이나 arXiv 원고는 아직 없습니다
DevChoco 제품 보기